Series Bên trong một LLM · Bài 2/5
Mô hình không nhìn thấy chữ, nó nhìn thấy token
Mô hình giải được bài khó mà đếm sai chữ cái trong một từ. Mình thắc mắc mãi, hoá ra lỗi nằm ở bước cắt chữ, trước khi nó kịp nghĩ.
Nó sai ở việc trẻ con cũng làm được
Bạn bảo chatbot lấy 4 ký tự cuối của mã đơn "INV-2024-001". Nó lúng túng.
Bạn hỏi 9.11 có lớn hơn 9.9 không. Lúc đúng lúc sai, mà lập luận nghe rất tự tin.
Mình gặp cảnh này hoài khi làm SaaS: một việc tưởng cỏn con lại tốn nhiều lần thử sai hơn cả một truy vấn nghiệp vụ phức tạp.
Lý do không nằm ở chuyện mô hình thông minh hay không. Nó nằm ở một thứ rất cơ khí: mô hình không nhìn thấy ký tự. Nó nhìn thấy token.
Phần dưới mình dựa vào chương tokenization trong bài giảng của Andrej Karpathy. Video đầy đủ ở cuối bài.
Trong đầu mô hình chỉ là một dãy số
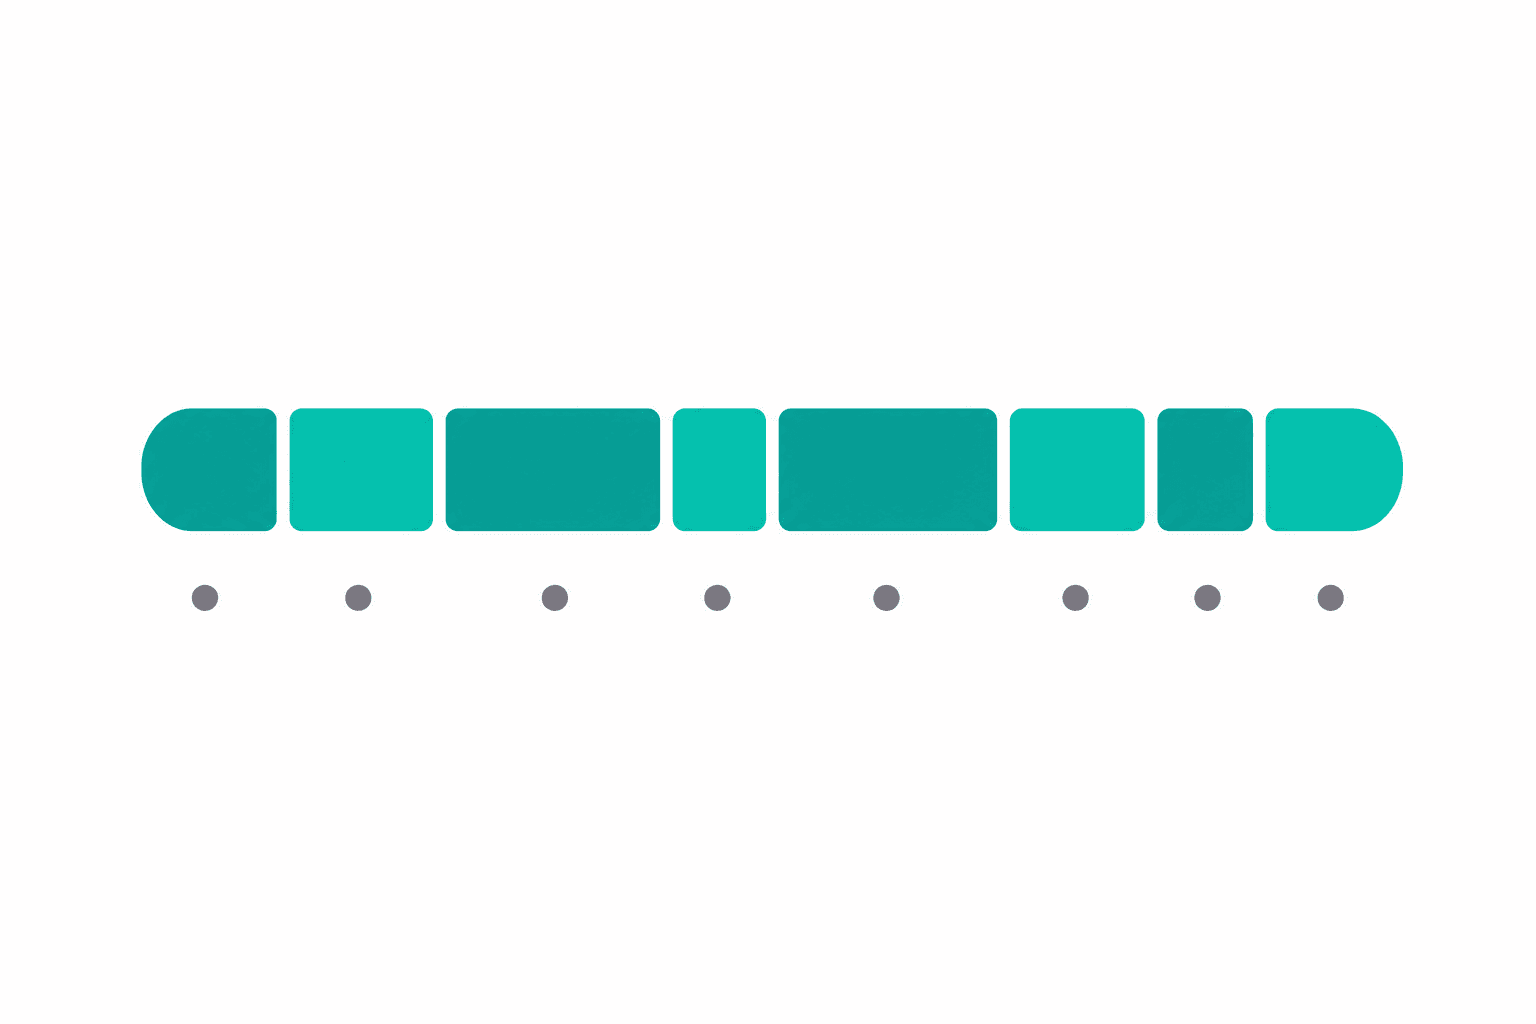
Trước khi vào mạng nơ ron, chữ được đổi thành một dãy số. Mỗi số là ID của một mẩu văn bản, gọi là token.
Bạn nhìn vào thấy một dòng chữ. Mô hình thấy [3512, 98, 40213, ...]. Không có hình dạng chữ cái, không có khoảng cách dòng, không "nhìn" được từng ký tự như mắt người.
Chỗ này quan trọng, vì mọi phép tính của nó đều diễn ra trên dãy số đó. Nó đoán token kế tiếp, không phải chữ cái kế tiếp.
Vì sao phải cắt thành token
Đây là một bài toán đánh đổi giữa hai thứ: kích thước từ điển và độ dài chuỗi.
- Cắt theo ký tự: từ điển nhỏ gọn, linh hoạt. Nhưng chuỗi rất dài, mà độ dài chuỗi là tài nguyên đắt trong mô hình. Dài quá thì vừa tốn tiền vừa khó học.
- Cắt theo từ: chuỗi ngắn lại. Nhưng từ điển phình khổng lồ, đầy từ hiếm, biến thể, tên riêng, từ mới.
Cách giải thực dụng là cắt thành mẩu nhỏ hơn từ, gọi là subword. Thuật toán sẽ gộp dần những cặp ký hiệu hay đi cùng nhau để tạo mảnh mới. Nhờ vậy mấy chuỗi phổ biến như "th", "ing" hay cả "hello" thành token riêng.
Kết quả: chuỗi ngắn đi đáng kể, từ điển vẫn hữu hạn. Thực tế từ điển thường cỡ hàng trăm nghìn token, tuỳ mô hình.
| Cách cắt | Ưu | Nhược |
|---|---|---|
| Ký tự hoặc byte | Từ điển nhỏ, đơn giản | Chuỗi rất dài, tốn tài nguyên |
| Từ hoàn chỉnh | Chuỗi ngắn | Từ điển cực lớn, kém linh hoạt với từ hiếm |
| Subword | Cân bằng được cả hai | Khó nhìn xuống tới từng ký tự |
Token không bằng từ, và khoảng trắng cũng là token
Đây là chỗ hay gây bất ngờ nhất. Một token thường chỉ là một mẩu từ. Và dấu cách nằm trong token chứ không phải không khí.
Vài điều lạ tai:
- "hello" có thể là một token, nhưng "he" và "llo" cũng có thể là token riêng ở bối cảnh khác
- "hello world" ra 2 token, còn "helloworld" có thể ra 3. Chỉ cần dính liền là cách cắt đổi.
- " hello" (có dấu cách đầu) khác với "hello". Hai dấu cách liên tiếp lại càng khác.
- "Hello" khác "hello". Cùng mặt chữ, khác token.
Với người dùng thì mấy khác biệt này vô hình. Với mô hình, đó là thế giới thật mà nó nhìn thấy.
Ví dụ gần gũi:
- Trong chatbot nội bộ, tìm "Tuấn" và tìm " Tuấn" (dư một dấu cách) có thể ra kết quả khác nhau
- "Xin chào Tuấn" và "xin chào Tuấn" đi qua đường token khác nhau. Nó vẫn hiểu ý chung, nhưng khi cần xử lý chính xác từng mẩu thì khác biệt lộ ra ngay.
Hệ quả: trí tuệ răng cưa
Vì không thấy ký tự nên mấy việc thao tác trên từng chữ cái thường tệ hơn bạn tưởng. Không phải nó ngu, mà là nó bị bịt mắt đúng ở cấp độ đó.
- Đếm ký tự: "Có bao nhiêu chữ r trong strawberry?" Tưởng dễ. Hỏi mấy lần có khi ra mấy đáp án.
- So sánh số thập phân: "9.11 có lớn hơn 9.9 không?" Nó giải được bài toán khó hơn nhiều, mà lại trượt ở đây.
Người ta gọi đây là trí tuệ răng cưa: cùng một mô hình làm được việc cực khó rồi ngã ở việc rất dễ. Ranh giới việc nó làm được không khớp với trực giác của mình.
Hai tình huống mình gặp khi làm sản phẩm:
- Chuẩn hoá mã hàng: bảo nó đảo ngược chuỗi "SP-001-AB", nó đảo sai một mẩu hoặc giữ dấu gạch không nhất quán
- Xác thực dữ liệu: "mã đơn phải đúng 12 ký tự, 3 chữ cái đầu". Nó đếm sót, vì nó không truy cập được từng ký tự như một chương trình bình thường.
Cách xử lý: bắt nó dùng công cụ
Việc nào cần chính xác từng ký tự hoặc cần tính toán đúng, mình không để nó tự nhẩm.
- Xử lý chuỗi → bắt nó viết code để đếm, cắt, đảo, chuẩn hoá. Code thao tác thẳng trên ký tự, không đi vòng qua token.
- Tính toán → bắt nó gọi hàm hoặc thư viện số học
Cách nhắc mình hay dùng:
"Dùng công cụ code để xử lý ký tự, đừng giải thích miệng."
"Tính bằng hàm, rồi trả về cả kết quả lẫn đoạn code đã chạy."
Ví dụ ngắn:
# Đếm ký tự 'r' và lấy mỗi ký tự thứ 3
s = "strawberry"
count_r = s.count("r")
every_third = s[::3]

# So sánh số thập phân
from decimal import Decimal
is_greater = Decimal("9.11") > Decimal("9.9")
(count_r, every_third, is_greater)
Áp vào việc thật:
- Làm sạch dữ liệu: cho mô hình viết quy tắc, nhưng chạy quy tắc đó bằng code trên dữ liệu thật. Mô hình mô tả, công cụ thực thi.
- Kiểm tra mã: bắt nó mô tả logic trước, rồi bắt chạy bằng hàm. Kết quả kiểm tra lại được.
- So sánh số: chuẩn hoá định dạng rồi chuyển sang Decimal mới so, đừng để nó nhảy qua float.
Nếu không có công cụ nào cả, bạn có thể ép nó liệt kê từng ký tự kèm chỉ số. Cách này đỡ sai hơn, nhưng vẫn không ăn được code.
Tóm lại
- Mô hình xử lý dãy token, không nhìn thấy ký tự
- Cắt theo ký tự thì chuỗi quá dài, cắt theo từ thì từ điển quá lớn, nên người ta cắt theo subword
- Một token thường là mẩu từ. Hoa thường và dấu cách đứng trước đều tạo ra token khác nhau.
- Vì vậy nó kém ở việc đếm, đảo chuỗi, so sánh số, dù giải được bài khó hơn nhiều
- Cần chính xác thì bắt nó dùng công cụ. Để nó tự nhẩm là mời rủi ro vào quy trình.
- LLM
- Tokenization
- AI