Series Bên trong một LLM · Bài 1/5
Pretraining: từ một đống văn bản internet thành mô hình cơ sở
Lọc cả internet, cắt thành token, rồi bắt mạng nơ ron đoán token kế tiếp hàng nghìn tỉ lần. Thứ ra lò chưa phải trợ lý đâu, mới là cái máy viết tiếp thôi.
Copy cả internet vào máy thì có ra ChatGPT không?
Câu này mình nghe nhiều lắm. Kiểu: chỉ cần tải hết chữ trên internet về, nhét vào một mạng thần kinh, bấm Train rồi ngồi chờ nó thành trợ lý ảo.
Câu trả lời ngắn: không.
Trước đó có một giai đoạn rất dài và rất tốn tiền tên là pretraining. Và thứ ra lò sau giai đoạn này chưa phải trợ lý, mới chỉ là một cỗ máy biết viết tiếp theo văn phong internet.
Bài này nằm trong series mình ghi lại từ bài giảng của Andrej Karpathy về cách LLM được huấn luyện. Video đầy đủ để ở cuối bài.
Dữ liệu thô: bỏ đi nhiều hơn giữ lại
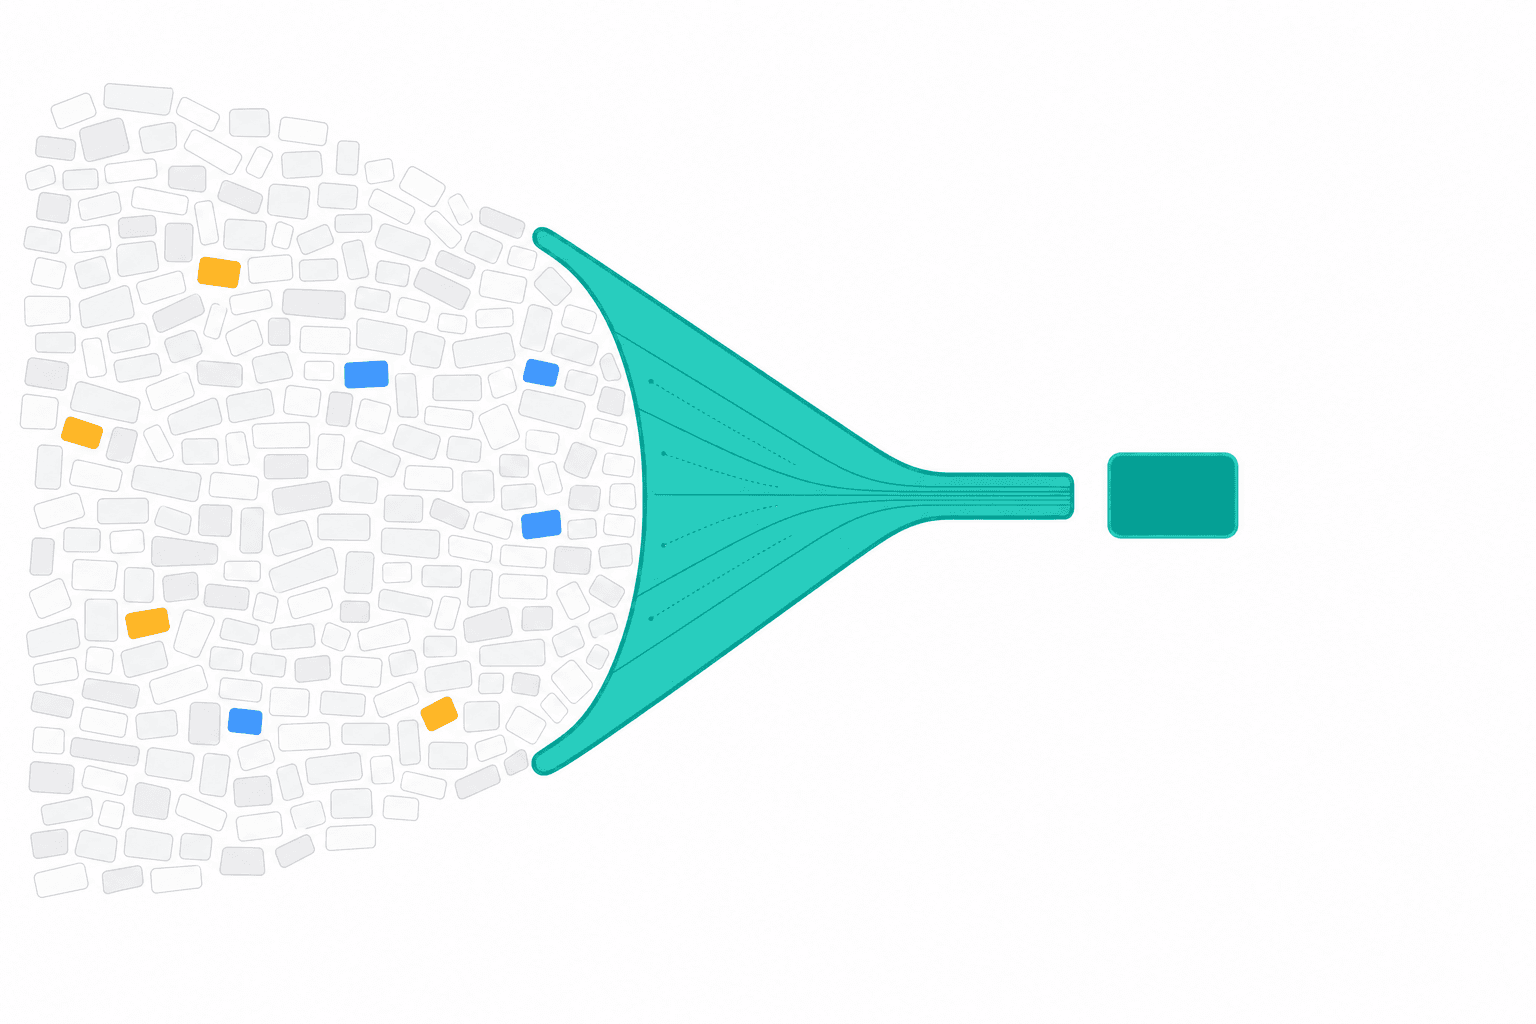
Internet lộn xộn kinh khủng. Muốn huấn luyện được thì phải lọc qua nhiều tầng, và điều bất ngờ là phần bỏ đi lớn hơn phần giữ lại rất nhiều.
Không phải càng nhiều càng tốt. Phải đúng, sạch và đa dạng.
Một quy trình lọc thường có mấy bước này:
| Bước | Làm gì | Vì sao |
|---|---|---|
| Lọc tên miền | Bỏ mấy miền độc hại, spam, quảng cáo, nội dung người lớn | Đừng đưa rác vào mô hình |
| Bóc chữ ra khỏi HTML | Chỉ giữ nội dung chính, bỏ menu, mã nguồn, CSS | Mô hình cần chữ, không cần khung trang |
| Nhận diện ngôn ngữ | Đoán từng trang viết bằng tiếng gì, chỉ giữ tiếng mình cần | Dữ liệu nghiêng tiếng nào thì mô hình giỏi tiếng đó |
| Khử trùng lặp | Bỏ nội dung bị copy đi copy lại | Tránh học vẹt, tránh lệch thống kê |
| Gỡ thông tin cá nhân | Bỏ địa chỉ, số định danh | Giảm rủi ro riêng tư |
Riêng chuyện bóc chữ ra khỏi HTML đã là một dự án. Mắt người nhìn vào thấy một bài viết, còn máy thấy một mớ thẻ, script và trang trí. Phải lựa cho đúng phần chữ có ý nghĩa.
Nhận diện ngôn ngữ cũng là một quyết định sản phẩm, không phải bước kỹ thuật vô hại. Giữ chủ yếu tiếng Anh thì mô hình sẽ rất giỏi tiếng Anh và kém hơn hẳn ở các tiếng khác. Đó là lựa chọn của người làm.
Lọc xong hết thì lượng chữ còn lại nhỏ hơn bạn tưởng nhiều. Internet khổng lồ thật, nhưng phần dùng được để dạy mô hình chỉ là một lát rất mỏng.
Từ chữ sang token
Chữ sạch rồi thì đưa qua bước cắt thành token. Token là đơn vị nhỏ của văn bản: có thể là một ký tự, một âm tiết, hoặc một mẩu từ.
Bộ cắt sẽ biến cả khối chữ thành một dãy số nguyên. Mỗi số là ID của một token trong từ điển đã định sẵn.
- Đầu vào của mạng là một chuỗi token, dài ngắn tuỳ, nhưng có trần vì lý do tài nguyên
- Đầu ra là một bảng xác suất trải trên toàn bộ từ vựng: với bối cảnh này, token nào dễ xuất hiện tiếp theo nhất
Tất cả chỉ là số. Không có chỗ nào cài sẵn khái niệm "hiểu nghĩa" cả. Ý nghĩa, nếu có, xuất hiện là vì mô hình học được mấy quy luật thống kê lặp đi lặp lại trong dữ liệu.
Bài tập duy nhất: đoán token kế tiếp
Nghe hơi khó tin, nhưng nhiệm vụ huấn luyện ở giai đoạn này đơn giản tới mức gây sốc: cho mô hình một đoạn token, bắt nó đoán token tiếp theo.
Không ai ngồi dán nhãn đúng sai thủ công cả. Đáp án đã nằm sẵn trong văn bản thật rồi.
Vòng lặp diễn ra thế này:
- Chọn ngẫu nhiên một cửa sổ token từ dữ liệu
- Bắt mô hình đoán xác suất cho mọi token có thể là "tiếp theo"
- So với token thật. Token thật lẽ ra phải có xác suất cao hơn.
- Chỉnh tham số của mạng một chút, để xác suất đó tăng, mấy lựa chọn khác giảm
- Lặp lại trên vô số cửa sổ khác, theo lô lớn, chạy song song
Lúc đầu toàn bộ tham số là số ngẫu nhiên, nên dự đoán cũng ngẫu nhiên nốt. Qua rất nhiều lần chỉnh nhỏ, mô hình dần khớp với mấy quy luật trong dữ liệu.
Người huấn luyện ngồi nhìn chằm chằm một con số tên là loss. Loss giảm dần nghĩa là mô hình đang đoán ngày càng đúng.
Đoạn giả mã này giúp hình dung lúc nó học xong và bắt đầu sinh chữ:
prefix = "Hôm nay thời tiết Hà Nội"
while chưa đủ dài:
    probs = model.predict_next_token_distribution(prefix)
    next_token = sample_the_weighted_coin(probs)  # rút thăm theo xác suất
    prefix += next_token
Mỗi bước là một lần tung đồng xu, mà đồng xu đó bị làm lệch theo bảng xác suất mô hình vừa đoán. Đó là lý do đầu ra không lặp lại y hệt dữ liệu gốc, mà là một tổ hợp mới nhưng nghe "giông giống".
Thứ ra lò: cỗ máy viết tiếp, chưa phải trợ lý
Kết quả của pretraining không phải một người bạn hiểu chuyện. Nó là một cỗ máy bắt chước văn phong internet: đưa vào đoạn đầu, nó viết tiếp.
Hai ví dụ cho dễ hình dung:
- Bạn gõ "Làm sản phẩm SaaS, mình đang phân vân mô hình giá. Theo mọi người..." thì nó viết tiếp như một bài đăng diễn đàn. Thêm vài câu chia sẻ trải nghiệm, có khi lạc đề, không nhất thiết trả lời bạn.
- Bạn dán "Bug nghiêm trọng ở trang thanh toán. Phải làm gì tiếp theo?" thì thay vì liệt kê các bước xử lý, nó có thể viết tiếp như chuỗi bình luận: "Mình cũng gặp, có vẻ do..." rồi lan man.
Nó không cố tình trả lời sai. Nó đang bắt chước đúng cái nhịp hội thoại trên internet mà nó đã đọc.
Muốn thành trợ lý biết nghe và biết tuân thủ thì phải qua mấy bước tinh chỉnh sau. Pretraining chỉ đặt nền: học xem chữ nghĩa chảy như thế nào.
Kiến thức nằm ở đâu
Không nằm dưới dạng bản sao các trang web. Nó rải ra khắp hàng loạt tham số, kiểu như một ký ức mờ về những gì đã đọc.
Hệ quả:
- Nó không đảm bảo nhắc lại nguyên văn. Nó tạo ra chuỗi token có thống kê tương tự.
- Cùng một câu hỏi, hai lần hỏi có thể ra hai kết quả khác nhau, vì mỗi bước đều có rút thăm
- Dữ liệu nghiêng thể loại nào thì nó phản chiếu văn phong đó
Nhìn từ góc sản phẩm thì đây vừa là ưu vừa là nhược. Ưu vì nó tổng hợp và sáng tạo được. Nhược vì nó dễ trôi mạch, không bám yêu cầu, nếu không có cơ chế định hướng ở các bước sau.
Vì sao chỉ vài tổ chức làm nổi
Hai lý do, cả hai đều nặng:
Dữ liệu. Chỉ riêng thu thập, lọc, khử trùng lặp, gỡ thông tin nhạy cảm đã là một dự án kỹ thuật đồ sộ. Cần hạ tầng crawl, cần pipeline xử lý văn bản, cần vô số quyết định về chất lượng và độ đa dạng.
Tính toán. Huấn luyện là chỉnh tham số qua hàng tỉ lần đoán token, trên những lô rất lớn. Phải dùng cụm GPU chuyên dụng, phân tán qua nhiều máy, đồng bộ tham số liên tục. Quy mô và chi phí ở mức chỉ vài chỗ trên thế giới gánh nổi.
Nói cách khác, pretraining là bài toán hạ tầng: dữ liệu chuẩn, thuật toán chuẩn, và một cái xưởng tính toán cực nhanh để lặp mãi một thao tác nghe thì đơn giản.
Tóm lại
- Dữ liệu internet phải lọc nhiều lớp, phần bỏ đi vượt xa phần giữ lại
- Nhiệm vụ huấn luyện rất đơn giản: nhìn bối cảnh, đoán token kế tiếp, không cần dán nhãn thủ công
- Mô hình bắt đầu từ tham số ngẫu nhiên rồi được chỉnh dần cho khớp với văn bản thật
- Thứ ra lò là mô hình cơ sở biết viết tiếp, chưa phải trợ lý biết nghe lời
- Kiến thức nằm mờ trong tham số và mang tính xác suất, đầu ra là bản phối chứ không phải bản sao
- Chi phí tính toán cộng với pipeline dữ liệu phức tạp khiến chỉ vài tổ chức làm nổi
- LLM
- Pretraining
- AI